Fine tuning: ¿Realmente vale la pena?
Qué es el fine-tuning, cuándo compensa entrenar un modelo para tu empresa, cuándo basta con RAG o un buen prompt y cómo la arquitectura MoE cambia la decisión.
En un mundo donde las empresas buscan integrar la IA de una forma cada vez más personalizada, el concepto de fine-tuning (que en español podríamos traducir como “ajuste fino”) aparece como una posibilidad excelente para mejorar la eficiencia de los LLMs que utilizamos en nuestro día a día.
Al principio, veía esta alternativa como algo sumamente interesante. Tengo varios proyectos en los que un modelo especializado en un área concreta me vendría genial y muchas veces valoré esta opción, pero nunca llegué a dar el paso. Por eso, en este artículo quiero ayudarte a entender en qué consiste exactamente este concepto y darte las herramientas para que decidas si, en tu caso, vale la pena o no implementarlo en el core de tu empresa.
¿En qué consiste el fine-tuning?
El fine-tuning es un proceso que se centra en el entrenamiento adicional de los modelos de IA tras su creación inicial. Como ya os expliqué en el artículo de la semana pasada (donde hablaba sobre cómo funcionan los LLMs por dentro), las redes neuronales de estos modelos aprenden modificando unos números ocultos en sus miles de millones de neuronas. Esos números son los famosos parámetros, y son los responsables directos de que una IA te responda de una manera u otra, o de que sepa una cosa u otra. En ese entrenamiento posterior (el fine-tuning), el modelo reajusta algunos de esos parámetros para que sus respuestas se acerquen más a lo que tú deseas.
El entrenamiento del que hablo no es más que una constante predicción de palabras. A la red neuronal se le introducen textos sin acabar (o con huecos) y debe predecir cuáles son las palabras (o tokens si queremos ser más técnicos) que faltan. Una vez que lanza su predicción, esta se compara con el texto original. Si acierta, no pasa nada, pero si se equivoca, se calcula el error matemáticamente y se le devuelve al modelo para que realice un ejercicio de retropropagación. Es en este paso donde ajusta esos parámetros que os comentaba. En este entrenamiento no se suelen editar todas las capas de la red neuronal del modelo original. Por lo general, se “congelan” casi todas y el modelo prepara solo unas pocas de las últimas capas como elegibles para realizar estos ajustes de cara a no modificar todo el entrenamiento anterior.
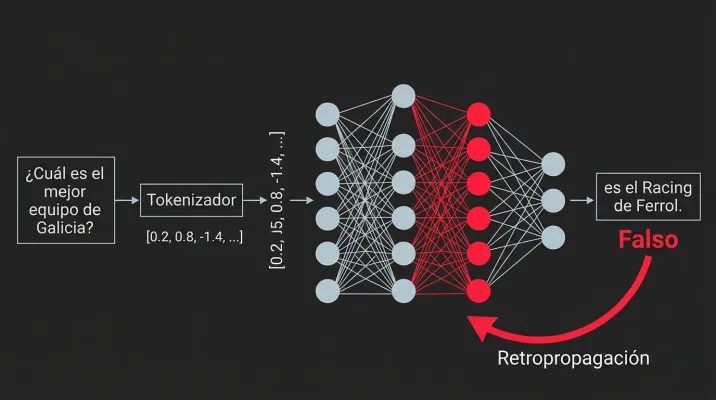
Un ejemplo de cómo es esa fase de entrenamiento en el fine-tuning.
Llevar a cabo este proceso implica, en la gran mayoría de los casos, descargar el modelo y tenerlo corriendo en un servidor privado. Normalmente, se utilizan modelos de código abierto que herramientas como Ollama permiten ejecutar de manera local. La gran desventaja de todo esto es el coste que tiene tanto el propio ajuste como el mantenimiento de la IA. Estamos hablando de necesitar GPUs con capacidades muy importantes (si queremos que el modelo vaya igual de rápido que los que consultamos vía API) y de contar con un equipo especializado para mantenerlo todo en orden. Aunque es importante destacar que empresas como OpenAI también ofrecen la opción de hacer fine-tuning sobre sus propios modelos gestionándolo ellos todo, esto no quita que siga suponiendo un coste elevado y, además, te deja con mucho menos control sobre el proceso de entrenamiento.
¿Cuándo entrenar un modelo?
Una vez ya entendemos lo que es realmente este proceso, vamos a ver los casos más típicos que nos generan la duda de si entrenar o no a un modelo:
Cuando quieres que un modelo sea un experto en tu empresa
Imagina que necesitas que la IA conozca vuestras políticas internas, el histórico de clientes o los manuales de recursos humanos. Podrías pensar que el fine-tuning es ideal, pero no lo es. No tiene sentido gastar todos esos recursos para que el modelo aprenda cosas que puedes cambiar constantemente. Aparte de que ese entrenamiento sería demasiado costoso y que no te asegura que el modelo sea capaz de siempre encontrar la información de manera adecuada.
Para este escenario es mucho mejor, barato y eficiente montar una arquitectura RAG (Retrieval-Augmented Generation). Con el RAG, le proporcionas al LLM una base de datos propia que podrá consultar con toda tu documentación. Cuando alguien le hace una pregunta, la IA busca primero la información en esos documentos y de ahí saca la respuesta exacta, evitando así que se invente cosas (alucinaciones) y ahorrándote el coste de reentrenar. Para cada pregunta convertirá el texto a números y buscará los vectores más parecidos haciendo así su búsqueda más efectiva. Es por ello que el fine-tuning en este caso no tiene sentido:
Cuando quieres que adopte un tono específico o evite ciertas palabras
Piensa en un despacho de abogados que necesita que el modelo responda a los clientes con un lenguaje muy formal, jurídico y sin decir ciertas palabras malsonantes, o que simplemente parezca redactado por un humano. En este caso, el fine-tuning sería matar moscas a cañonazos, ya que estaríamos cambiando unos parámetros para unos simples ajustes que podíamos incluir en su system prompt (que es la indicación que le damos inicialmente al modelo para que actúe en consecuencia en cada interacción que tenemos con él). Un prompt robusto, cargado de reglas claras y ejemplos concretos de cómo debe (y no debe) contestar (lo que se conoce como few-shot prompting), es suficiente para guiar al modelo a la perfección.
Cuando SÍ es útil el fine-tuning
Este ajuste brilla realmente cuando necesitas que el modelo realice una tarea muy de nicho o adopte un formato de salida extremadamente específico que un prompt normal no consigue estabilizar (por ejemplo, escupir siempre código en un lenguaje de programación interno y propietario, o devolver estructuras de datos JSON muy complejas de forma consistente). También es la opción ideal si quieres coger un modelo muy pequeño y barato, y entrenarlo en una única tarea repetitiva para que rinda tan bien como un modelo gigante, ahorrando así costes de inferencia y latencia a largo plazo. Pero en la mayoría de casos de uso de cualquier PYME en la actualidad, este ajuste no vale la pena.
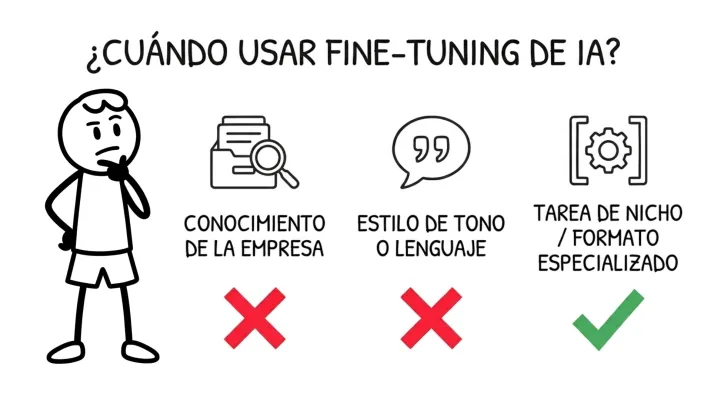
Resumen visual de esta sección.
Arquitectura MoE de los nuevos LLMs
Silicon Valley entendió muy bien la problemática que resolvían los modelos que habían pasado un ajuste con el fine-tuning. Si tu caso de uso era tener un LLM hiperespecializado en un gran campo de conocimiento general (como derecho, medicina o programación), te diré que hoy en día ya se han encontrado soluciones al fine-tuning gracias a la aparición de la arquitectura MoE (Mixture of Experts, o Mezcla de Expertos), la cual utilizan los modelos más punteros del mercado en la actualidad.
En lugar de tener una única y gigantesca red neuronal donde todas las partes se activan para responderte, un modelo MoE está compuesto por varias sub-redes neuronales más pequeñas. Cada una de ellas es un experto entrenado en un área distinta. Cuando tú le haces una pregunta al LLM, hay una pieza clave llamada enrutador (router) que analiza tu petición y decide a qué experto (o expertos) debe enviarle el trabajo. Si le pides que programe una web, activa al experto en código, si le preguntas sobre la Revolución Francesa, activa al experto en historia. El modelo solo utiliza las partes que realmente necesita para esa consulta, siendo increíblemente rápido y preciso.
Esta nueva arquitectura sustituye casi por completo a los antiguos modelos fine-tuneados que buscaban ser expertos en una materia, ya que los modelos MoE traen especialistas integrados de fábrica con un rendimiento espectacular.
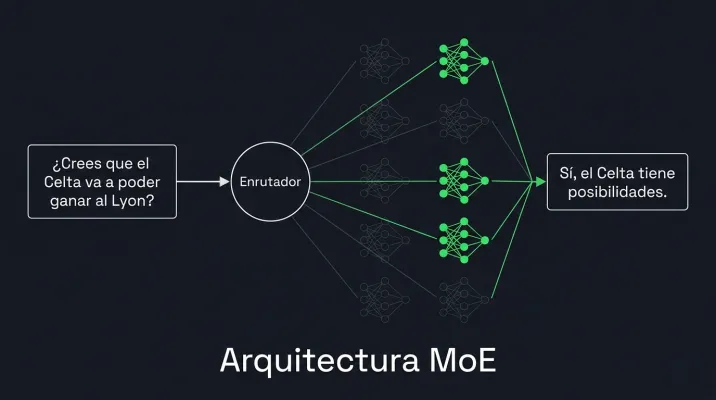
Funcionamiento actual de los LLMs cuando le haces una pregunta sobre un tema en específico.
Sin embargo, no los sustituye en todo. Como te comentaba antes, si necesitas que la IA aprenda formatos muy particulares, tareas de clasificación hechas a medida para tu negocio, o maneras de pensar que no existen de forma pública en internet, los modelos MoE seguirán quedándose cortos. En esos casos tan concretos, el fine-tuning seguirá siendo tu mejor aliado.
Espero que este artículo te haya ayudado a entender este concepto y que desencadene buenas decisiones en la implantación de IA en tu empresa. Nos vemos la semana que viene con más contenido :)
Preguntas frecuentes
¿Qué es el fine-tuning de un modelo de IA?
Es un entrenamiento adicional sobre un modelo que ya existe: se le dan textos con huecos, predice las palabras que faltan y, cuando falla, la retropropagación ajusta algunos de sus parámetros. Normalmente se congelan casi todas las capas y solo se reentrenan las últimas.
¿Fine-tuning o RAG para usar la IA con los datos de mi empresa?
RAG. Si quieres que la IA responda con la información de tu empresa (políticas, clientes, manuales), un RAG le deja consultar tus documentos en cada pregunta, se actualiza sin reentrenar y reduce las alucinaciones. El fine-tuning solo compensa cuando lo que hay que cambiar es el comportamiento del modelo, no lo que sabe.
¿Cuándo vale la pena hacer fine-tuning?
Cuando necesitas un formato de salida muy específico que un prompt no consigue estabilizar (por ejemplo, JSON complejo o un lenguaje de programación propietario), una tarea de clasificación propia de tu negocio, o entrenar un modelo pequeño para que haga una única tarea tan bien como uno grande, con menos coste y latencia.
¿Qué es un modelo MoE (Mixture of Experts)?
Es un modelo formado por varias subredes expertas en distintas áreas. Un enrutador analiza cada petición y activa solo los expertos necesarios, de modo que responde rápido y con precisión sin usar toda la red.