¿Los modelos chinos valen realmente la pena para introducirlos en tus ciclos de desarrollo?
Probé OpenCode Go con DeepSeek V4 Pro y Kimi K2.6 frente a Claude Code: calidad casi igual por 10 € al mes, pero más lento y con algún bucle.
Los sábados por la mañana son mi momento de I+D interno. Cojo las noticias de IA de la semana, filtro las que pueden marcar diferencia real, y me paso horas probándolas. Esta semana le tocó a OpenCode con su plan de suscripción basado en modelos de IA open weights. Este agente de codificación que llevaba tiempo queriendo testear en serio, se ha hecho realmente conocido por permitir con apenas 10 euros al mes poder crear código sin límites.
Hasta ahora usaba Claude Code en el plan de pago pro, con una capacidad tan reducida que en la práctica apenas servía para proyectos reales. Con esa frustración encima, entré por primera vez en OpenCode y me encontré con un paradigma distinto. Uno que merece que le dediques unos minutos. En este artículo te voy a explicar un poco cómo ha sido mi experiencia con esta herramienta y las conclusiones a las que he llegado.
Facilidad de uso
La experiencia en consola se siente igual que Claude Code en lo que a planificación y edición de código se refiere. Se sigue la misma lógica, cuando quieres hacer una funcionalidad grande usas Plan para que la IA lea todo tu código y prepare una estrategia, y cuando acaba, usas Build para que cree cada parte de ese plan. Si buscas hacer un cambio más pequeño, Build vuelve a ser la modalidad a usar para ello.
Nunca he sido muy fan de trabajar en la terminal, pero con OpenCode se siente muy cómodo desde allí. Siento que la interfaz es algo más visual que Claude Code y que la manera de mostrar la información es más elegante. En todo momento puedes ver cómo de grande es la ventana de contexto y que porcentaje de uso te queda en ella. Además de eso, puedes ver exactamente cuánto dinero real estás gastando en ese chat con total transparencia, algo que en otras herramientas era impensable. Y por último, el poder ver el to-do constantemente es algo que creo que puede aportar mucho valor.
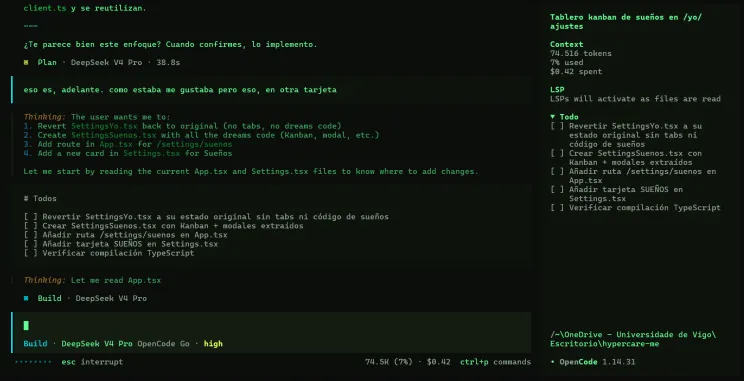
OpenCode en acción siguiendo un Plan
Calidad de respuestas
Okay, el uso puede ser más o menos cómodo, pero vamos a lo importante: ¿La calidad del código de los modelos chinos es realmente buena o está a años luz de Claude? Porque claro, pasas de pagar 100 euros al mes a apenas 10. El cambio debe ser muy grande, ¿no?
Pues mi opinión es que no. Creo que existe una diferencia grande en algunos desarrollos específicos, pero que en la mayoría de los casos los modelos chinos pueden dar un rendimiento parecido que los modelos SOTA del mercado como son los de Claude. Y para ello me remito a lo más objetivo que existe para medir esta diferencia, los benchmarks de código.
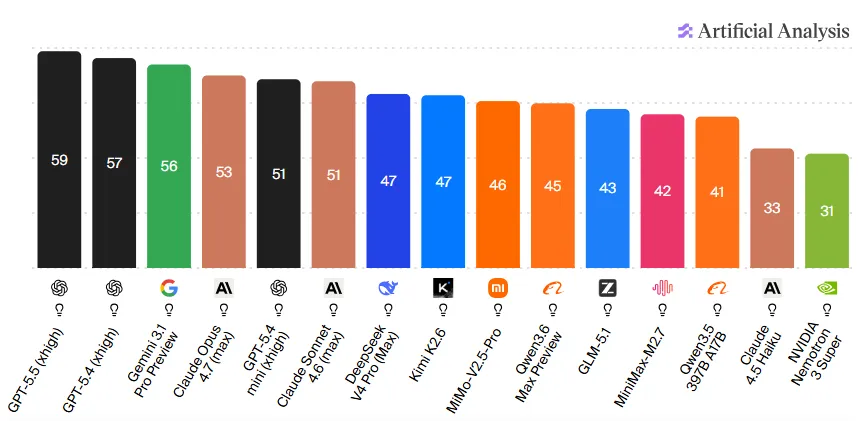
Artificial Analysis Coding Index a 3 de Mayo de 2026
La mayoría del tiempo, los usuarios de Claude Code (sobre todo que no están en el plan de 100 euros) usan Sonnet 4.6 para la mayor parte de sus desarrollos. En el benchmark que precede a este texto se ve como este modelo con la mayor capacidad de recursos posible, está apenas 4 puntos por encima de DeepSeek V4 Pro.
El problema de este gráfico es que no muestra la realidad. Si usas Sonnet a esa potencia para tu desarrollo tu sesión se expirará en muy poco tiempo, dejándote 5 horas parado mientras esperas a que vuelva a funcionar. Esto nos fuerza muchas veces a usar Sonnet en su versión medium. Si usas DeepSeek en su máximo uso de recursos lo más probable es que tu sesión se prolongue varias horas y que puedas realizar todas las tareas que te propusiste. Y lo más seguro es que esa calidad sea un poco mejor que la del propio Sonnet a mitad de su capacidad. Estás trabajando con un modelo casi igual de capaz que Sonnet max, pero sin las restricciones del plan Pro de Claude.
En las pruebas que hice esta semana la calidad de respuestas fue muy buena, y el cambio respecto a Sonnet es prácticamente imperceptible para el 90% de los casos reales. La diferencia sí se notaría si usaras Opus, pero ese modelo es tan restrictivo en Pro que apenas he podido testarlo en condiciones reales.
Capacidad de uso
Todo lo anterior tiene aún más sentido cuando miras los números.
OpenCode Go (su suscripción básica enfocada al uso de modelos chinos) cuesta 5 euros el primer mes y alrededor de 10 euros mensuales después. Por ese precio, el plan incluye los siguientes límites de uso:
- Límite de 5 horas: equivalente a $12 de consumo
- Límite semanal: equivalente a $30 de consumo
- Límite mensual: equivalente a $60 de consumo
Los límites se calculan en valor en dólares, lo que significa que la cantidad real de peticiones depende del modelo que uses. Modelos más económicos como DeepSeek V4 Flash permiten hasta 31.650 peticiones en 5 horas, mientras que modelos más potentes como Kimi K2.6 rondan las 3.450. Cifras muy complicadas de llegar si le metes mucha caña en tus ciclos de desarrollo.
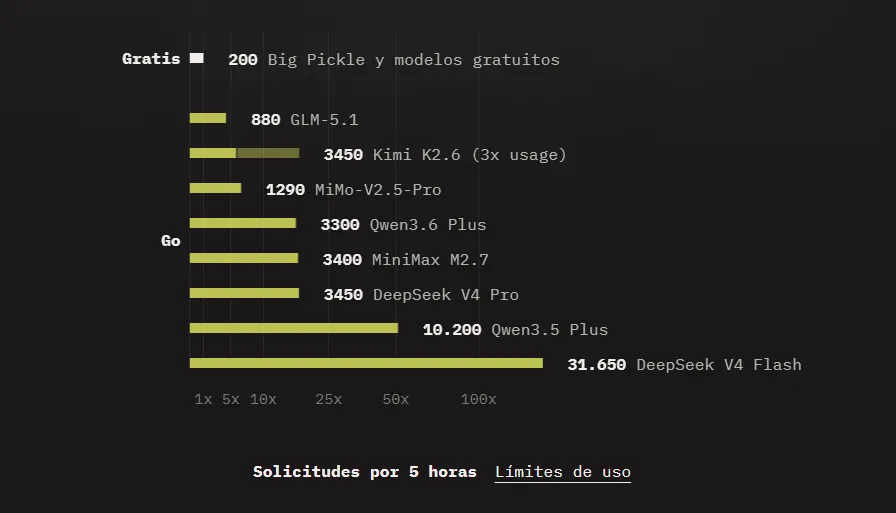
Peticiones disponibles por modelo según estimaciones de OpenCode.
¿Cómo se traduce esto en uso real? El sábado que lo probé, con 5 horas de trabajo continuo, varios chats abiertos mejorando un proyecto en paralelo, ni siquiera llegué al límite, bueno ni me acerqué. Como podéis ver en el dashboard, apenas gasté un porcentaje del consumo disponible. Y sí, usando sus modelos chinos más punteros al máximo de sus capacidades. Simplemente sensacional.
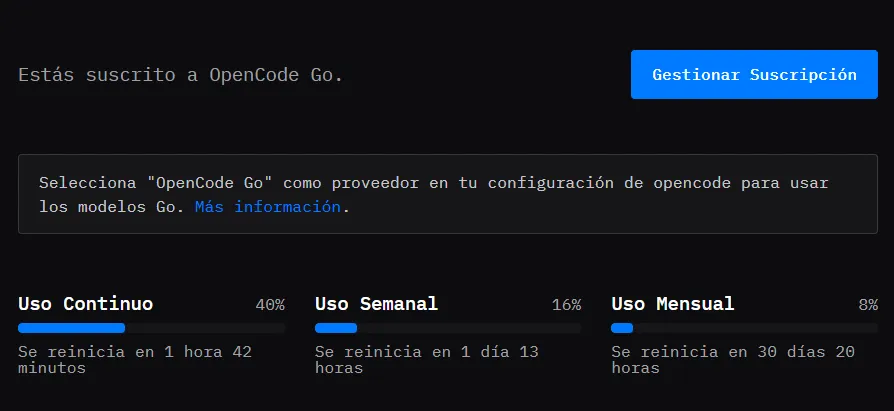
Uso de OpenCode en 4 horas y con 5 chats abiertos a la vez.
Velocidad de desarrollo
Sin embargo, todo este entusiasmo inicial se frenó un poco al evaluar la velocidad del desarrollo. Cuando le pides al agente que pase de la fase de planificación a la de construcción, el proceso puede hacerse demasiado lento. Llegué a sufrir ciclos de espera de hasta 20 o 30 minutos para que ejecutara el plan acordado, y lo frustrante es que esto no ocurría por la cantidad de código que debía generar, sino por cómo gestiona el sistema estas peticiones.
Además, me topé con un problema importante en varios chats. Aún teniendo la ventana de contexto apenas al 25% de su capacidad, el agente entraba en un bucle del que no salía, siendo incapaz de finalizar la tarea o avanzar de forma real. Este fallo lo sufrí principalmente utilizando DeepSeek V4 Pro, lo que me lleva a pensar que, al ser modelos autoalojados en los propios servidores de OpenCode, su infraestructura puede estar sufriendo cuellos de botella que provocan estos errores. Al inicio con Kimi K2.6 la historia fue muy distinta y no experimenté ninguno de estos bloqueos.
Después de un sábado entero probándolo, OpenCode Go está en mi stack. De momento no como sustituto permanente de Claude porque considero que desde el chat aún me aporta mucho valor, pero sí como la opción principal para sesiones largas de desarrollo donde necesito autonomía real, iteraciones de ideas rápidas y mucho consumo. Por 10 euros al mes, la propuesta de valor es difícil de rebatir y si le pones esta calidad se te hace complicado pensar en que cambiar siga siendo una opción.
Si trabajas con código y todavía no lo has probado, ponlo en tu lista para el próximo sábado por la mañana. Y si ya lo usas, cuéntame qué modelo estás usando y cómo te está funcionando, porque tengo curiosidad por saber si DeepSeek V4 Pro está siendo tan consistente para otros como lo está siendo para mí.
Muchas gracias por leerme, espero haberte echado un cable.
Preguntas frecuentes
¿Qué es OpenCode Go?
Es la suscripción básica de OpenCode, un agente de programación para la terminal parecido a Claude Code, centrada en modelos open weights como DeepSeek V4 Pro, DeepSeek V4 Flash o Kimi K2.6. Cuesta 5 € el primer mes y unos 10 € al mes después.
¿Son los modelos chinos tan buenos como Claude para programar?
Para la mayoría de tareas, casi. En el Coding Index de Artificial Analysis de mayo de 2026, DeepSeek V4 Pro está a 4 puntos de Claude Sonnet 4.6 a máximo rendimiento, y en pruebas reales la diferencia fue imperceptible en el 90 % de los casos. Frente a Claude Opus la diferencia sí se nota.
¿Cuánto se puede usar OpenCode Go al mes?
Los límites se miden en dólares de consumo: 12 $ cada 5 horas, 30 $ a la semana y 60 $ al mes. Según las estimaciones de OpenCode, eso equivale a hasta 31.650 peticiones cada 5 horas con DeepSeek V4 Flash o unas 3.450 con Kimi K2.6.
¿Qué problemas tiene OpenCode con los modelos chinos?
Sobre todo la velocidad: pasar del modo Plan al modo Build puede tardar 20 o 30 minutos. Además, con DeepSeek V4 Pro el agente entró en bucles sin terminar la tarea aunque el contexto estaba al 25 %, posiblemente por cuellos de botella en los servidores de OpenCode. Con Kimi K2.6 no pasó.