¿Qué modelo de IA uso para cada tarea? Esto dicen los benchmarks
Qué son los benchmarks de IA y qué modelo elegir en 2026 para redactar, programar, generar imágenes o crear agentes, según LLM Arena y Artificial Analysis.
En la carrera tecnológica actual, cada semana aparece un nuevo modelo de lenguaje (LLM) que dice ser “el más inteligente del mundo”. Pero ¿cómo podemos verificarlo sin caer en el marketing de las empresas? ¿Cómo podemos creernos esos datos?
Aquí es donde los benchmarks se vuelven esenciales. Mi propósito hoy no es solo responder a la duda del título con la foto actual de este 4 de febrero de 2026, sino enseñaros a leer estas métricas para que, de ahora en adelante, tengáis el criterio necesario para elegir vuestra propia IA.
¿Qué son los Benchmarks de IA?
Un benchmark es, en esencia, un examen estandarizado. Al igual que los humanos hacemos la selectividad para medir nuestros conocimientos académicos, las IAs se someten a pruebas diseñadas para evaluar su capacidad de razonamiento, programación, matemáticas o comprensión de lectura. A diferencia de los exámenes humanos, el gran reto de los benchmarks de IA es asegurar que el modelo no haya visto las preguntas antes y que por ende, el modelo no pueda aprender la respuesta en su fase de entrenamiento. Sin estos “exámenes”, sería imposible comparar un modelo de Google con uno de OpenAI de forma justa, ya que cada uno “vende” sus resultados de manera distinta.
En los benchmarks de IA podemos dividir el análisis en dos filosofías diferentes. Podemos estudiar análisis como el de LLM Arena (Arena.ai) que se inclina por una medida subjetiva basada en la preferencia humana, mientras que otros estudios como los de Artificial Analysis (artificialanalysis.ai) apuestan por una métrica objetiva fundamentada en datos técnicos verificables (Existen más plataformas, pero en este artículo sólo me centraré en estas dos).
Uno sería como preguntar a un grupo de personas qué coche les gusta más conducir y otro sería directamente meter ese mismo coche en un túnel de viento para medir su aerodinámica exacta.
LLM Arena funciona mediante un sistema de votación ciega, similar a una cata de vinos, donde el usuario no sabe qué IA le está respondiendo hasta que emite su voto. Artificial Analysis, en cambio, opera como un laboratorio de alto rendimiento, sometiendo a los modelos a pruebas, midiendo diferentes variables y evaluando el éxito en exámenes estandarizados bajo condiciones controladas de computación.
Mejores modelos para tareas específicas
Una vez ya entendemos ese concepto de los benchmarks, es momento de analizar qué modelo es mejor para cada tarea comparando las opiniones y los resultados de los estudios objetivos.
Para entender el contenido que vamos a ver a continuación es importante explorar los conceptos que se ven en las tablas de LLMArena. En estas tablas, veremos métricas clave como la puntuación Elo (que mide la puntuación relativa del modelo), el intervalo de confianza (la precisión estadística del ranking) y el volumen de votos, todo ello basado en un estudio subjetivo global que abarca todos los idiomas para garantizar una visión universal de su utilidad.
Por otro lado, complementaremos esta visión con los datos de Artificial Analysis, cuyas gráficas presentan índices de calidad sintetizados. Estos índices se forman agregando resultados de múltiples exámenes técnicos objetivos (como MMLU-Pro o GPQA) y cruzándolos con variables de rendimiento, permitiéndonos visualizar de forma científica su rendimiento en distintas situaciones o características.
Redacción de texto
Este es sin duda el campo que más interés genera a todos. Al observar la tabla de clasificación de Arena.ai (actualizada a 29 de enero de 2026), queda claro que Google ha logrado una hazaña sin precedentes. Gemini-3-pro lidera el ranking global con una puntuación Elo de 1487 y un margen de error estrechísimo. Lo más sorprendente es que su versión ligera, Gemini-3-flash, se sitúa en el tercer puesto, superando incluso a modelos más potentes de la competencia.
Estos resultados demuestran una clara preferencia del usuario: cuando se trata de versatilidad lingüística y redacción, las personas eligen de forma masiva el estilo y la coherencia de Gemini. Otro detalle importante sobre el dominio de este modelo es la columna de Rank Spread. No es sólo el líder, sino que se sitúa en rango sólido de 1 ↔ 1, lo que estadísticamente lo confirma como el rey indiscutible de la utilidad percibida por el ojo humano. Lo cual en esta categoría tiene más peso que cualquier otro posible benchmark objetivo.
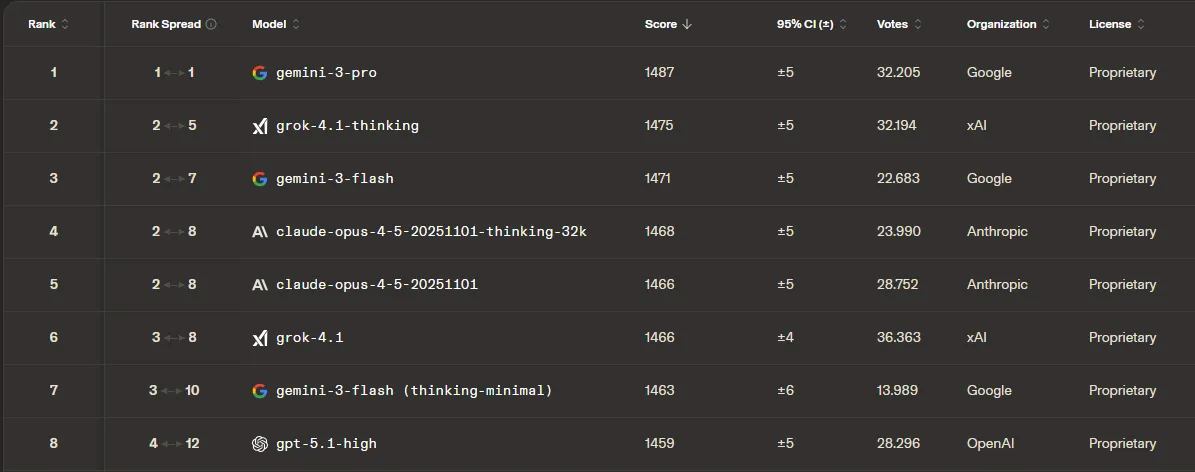
Text Arena de LLM ARENA
Para complementar esta visión humana subjetiva, recurrimos al Multilingual Index (Spanish Language) de Artificial Analysis. En su plataforma, este índice es la herramienta más cercana para evaluar la calidad del texto en nuestro idioma. Es importante notar que, aunque este benchmark se agrupa bajo la categoría de inteligencia, actúa como el mejor indicador objetivo disponible para medir la calidad del texto, ya que no existe un análogo directo que mida la belleza o fluidez de forma puramente objetiva. Según su última gráfica, Gemini 3 Pro Preview (high) encabeza el índice con 94 puntos, seguido de cerca por Claude Opus 4.5 con 93, lo que confirma la correlación entre la preferencia humana y la capacidad técnica del modelo en español.
El cálculo de este resultado general se basa en otros benchmarks, os recomiendo explorar la metodología para poder entender mejor los resultados.
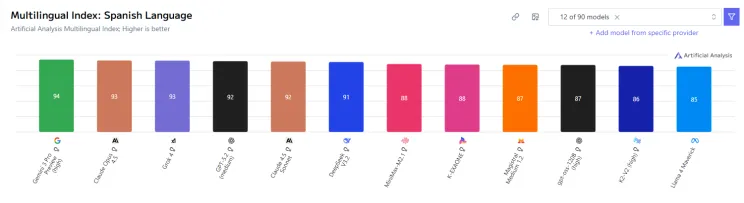
Multilingual Index: Spanish Language de Artificial Analysis
Código
Cuando pasamos a la categoría de código, el panorama cambia drásticamente, revelando una lucha mucho más reñida entre los gigantes del sector. Los últimos meses las empresas desarrolladoras de modelos de IA han hecho muchos esfuerzos por poner sus modelos en lo más alto de esta tabla por la gran demanda que existe con la creación de código con IA.
En la clasificación de Arena Coding, vemos como Claude-Opus-4.5-thinking-32k se corona como el mejor modelo para programar con una puntuación de 1500, con una holgada diferencia frente a su contendiente gpt 5.2 high. También es notable la presencia de modelos de código abierto o con licencias modificadas como GLM-4.7 y Minimax-m2.1-preview en el Top 8, lo que indica que el ecosistema abierto está alcanzando niveles de excelencia en tareas técnicas.
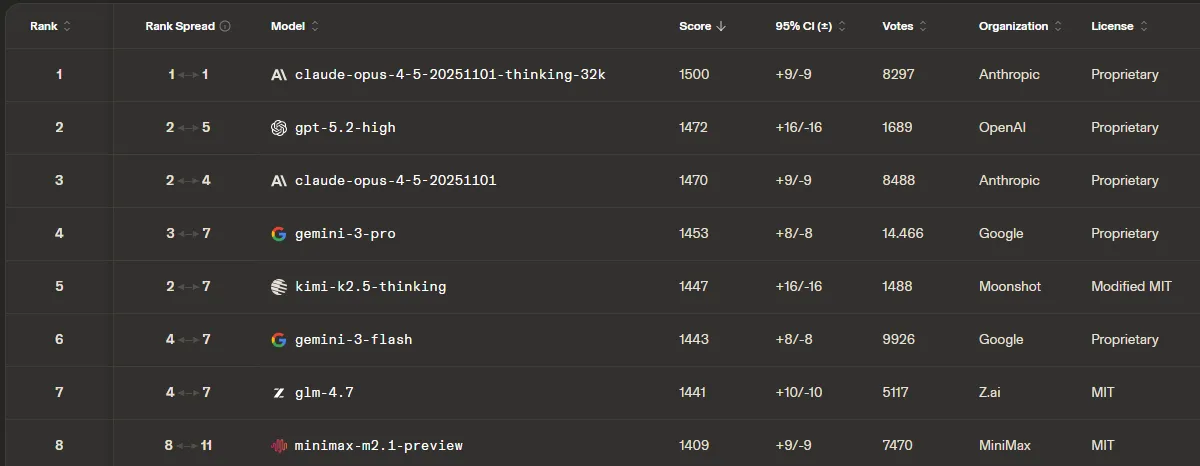
Code Arena de LLM Arena
El índice de código de Artificial Analysis reafirma que los resultados están extremadamente parejos, situando a los modelos de Claude, Gemini y OpenAI en una especie de empate técnico virtual en la cima. Este índice se forma mediante benchmarks altamente rigurosos entre los que figuran:
- SciCode: Evalúa la capacidad de programar en Python para resolver tareas complejas de computación científica.
- LiveCodeBench: Es quizás el más respetado, ya que utiliza problemas de plataformas como LeetCode o AtCoder publicados después del entrenamiento de los modelos para evitar la memorización (contaminación de datos).
El hecho de que GPT-5.2 high (87), Claude Opus 4.5 (86) y Gemini 3 Pro (86) tengan puntuaciones tan cercanas en este índice objetivo sugiere que hemos llegado a un punto de madurez donde los tres grandes proveedores ofrecen capacidades de programación de primer nivel, diferenciándose apenas por matices en la velocidad o el precio.
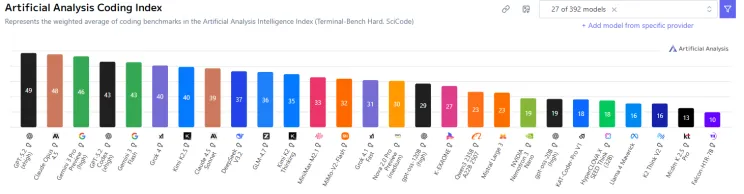
Artificial Analysis Coding Index de Artificial Analysis
Texto a Imagen
En el campo de la generación de imágenes, la subjetividad es, quizás, la métrica que más valor tiene (o por lo menos bajo mi punto de vista). Recientemente, se ha hablado mucho sobre cómo GPT-image-1.5-high-fidelity ha destronado a Nano Banana (Gemini 3 Pro Image). Ese rumor se ha convertido en hecho ya que en el ranking de preferencia vemos cómo se sitúa en el primer puesto con un Elo de 1236. Aunque como vemos, Nano Banana pro no se sitúa muy lejos del líder un rank spread 1 ↔ 3 que deja el debate abierto.
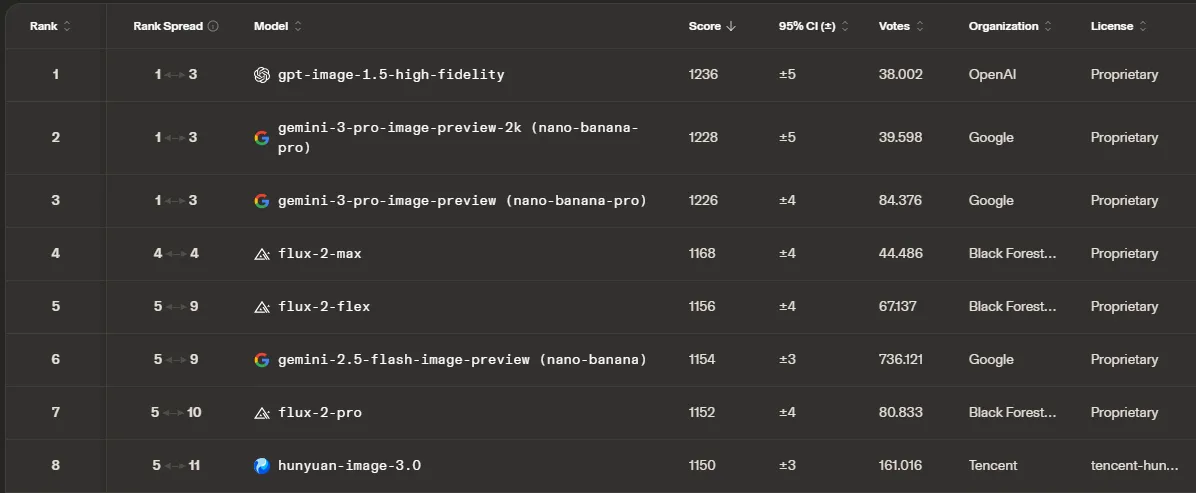
Text-to-image Arena de LLM Arena
En este caso, Artificial Analysis no ofrece un benchmark específico para esta categoría. Por ello, la opinión masiva recogida por los usuarios en una Arena (idéntica a lo que nos mostraba el análisis anterior) es su estándar usado. Al comparar ambas gráficas, vemos resultados prácticamente idénticos en el podio, confirmando a Nano Banana Pro y a GPT Image 1.5 como los claros vencedores en el campo de texto a imagen.
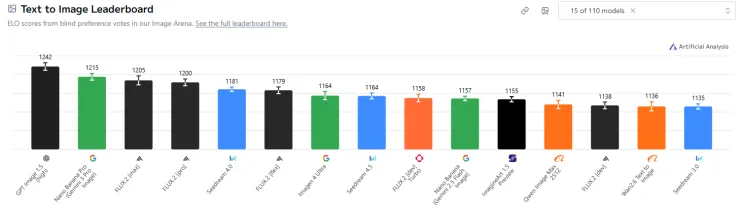
Text-to-image Arena de Artificial Analysis
Como veredicto final tras cruzar los datos de preferencia y rendimiento técnico, el panorama de liderazgo queda definido por especialidades:
- Gemini 3 Pro se corona como el modelo más versátil y capaz para la redacción general y el procesamiento de español.
- Claude Opus 4.5 (Thinking) se mantiene como la herramienta definitiva para los desarrolladores por su indiscutible superioridad en tareas de programación.
- En el apartado creativo visual, el trono ha pasado recientemente a manos de GPT-image-1.5, consolidándose como la opción favorita para la generación de imágenes de alta fidelidad según el consenso masivo de los usuarios.
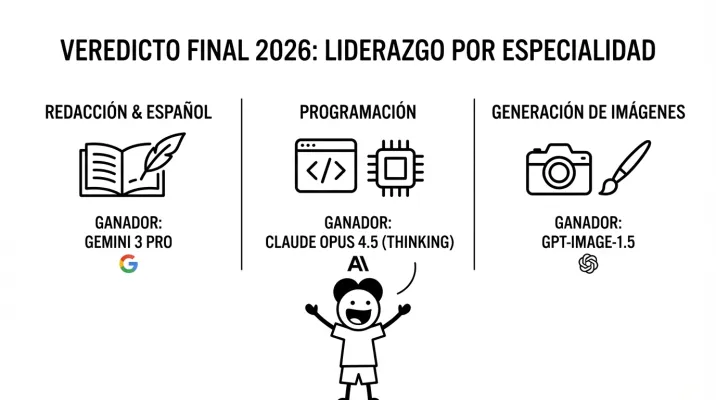
Mejores modelos por especialidad (Imagen hecha con Nano Banana Pro)
Mejores modelos para usar en desarrollos
Para cerrar este análisis, he querido centrarme en los temas que más nos importan como programadores y desarrolladores de automatizaciones al elegir qué modelo integrar en nuestros flujos, enfocándome en las categorías que siento más importantes tener en cuenta de cara a elegir el mejor modelo para nuestros desarrollos.
Agentes IA
Para empezar, vamos a ver cuáles son los modelos más idóneos para los agentes de IA. Y comenzamos con sorpresa. Resulta sorprendente ver lo abajo que han quedado los modelos de Google (Gemini) en comparación con los “nuevos” jugadores de código abierto. Vemos cómo otros modelos a priori “menos inteligentes”, usan mejor las herramientas que tienen a su disposición que otros modelos con mayor capacidad.
Modelos como Kimi K2.5, GLM-4.7 y DeepSeek V3.2 están compitiendo cara a cara con GPT-5.2 y Claude 4.5. Me ha sorprendido gratamente la eficiencia de estos modelos. Su capacidad para seguir instrucciones complejas y manejar herramientas me ha hecho replantearme seriamente su adopción en mis propios agentes de IA, ya que ofrecen una efectividad de gama alta a una fracción del coste habitual.
El hecho más destacable de que esos modelos estén tan arriba en la clasificación es que son significativamente más baratos que los líderes del mercado. Esto podría hacer que el consumo de los recursos de IA bajara drásticamente sin comprometer la eficacia de los desarrollos, lo cual me sorprende mucho y me hace cuestionarme muchas cosas.
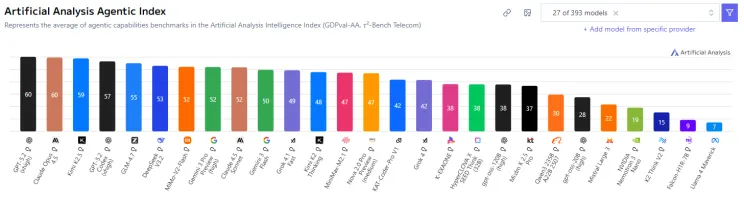
Artificial Analysis Agentic Index de Artificial Analysis
Para entender por qué un modelo está por encima de otro, es vital conocer los benchmarks utilizados. En este índice se han promediado dos pruebas estándares que evalúan el razonamiento de agente:
- GDPval-AA: Este indicador mide la validación de rendimiento en desarrollo general, analizando cómo el modelo desglosa tareas complejas en pasos lógicos y su precisión al ejecutar código o llamadas a funciones.
- Bench Telecom: Es un benchmark especializado en el uso de herramientas en dominios del mundo real. Específicamente, evalúa la capacidad del modelo para navegar por bases de datos, consultar APIs y resolver problemas de usuarios en un entorno técnico de telecomunicaciones, donde la precisión técnica es innegociable.
Inteligencia vs Coste
La siguiente gran preocupación que tenemos al usar agentes es el coste sin perder su efectividad en las tareas que requieren su inteligencia. Es por eso que no podía excluir a este benchmark de mi artículo.
Para despejar esa duda tenemos el índice de Inteligencia vs. Coste de Ejecución con una clara zona verde que nos indica cuáles son los modelos más interesantes. Y cómo nos anticipó el anterior benchmark, los modelos que más destacan son:
- DeepSeek V3.2: Que se confirma como una de las opciones más interesantes, ofreciendo una ventaja competitiva en precios sin sacrificar el rendimiento de agente, posicionándose con una inteligencia similar a modelos significativamente más costosos. Y sí, de ecosistema abierto.
- Gemini 3 Flash: Sigue consolidada como una de las mejores elecciones para producción. Su equilibrio entre bajo coste y alta capacidad de razonamiento la hace ideal para flujos de trabajo masivos. En lo personal, uno de los modelos que más uso en mis desarrollos.
- Grok 4.1 Fast: Conocida por ser uno de los modelos más usados vía API. Su ubicación muestra una eficiencia extrema, siendo un modelo muy ágil para desarrollos que requieren respuestas rápidas y económicas. Un modelo que no me para de sorprender, y que considero que puede ser muy interesante.
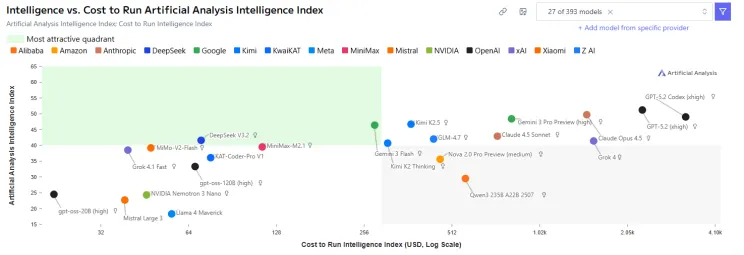
Intelligence vs Cost Index de Artificial Analysis
Este análisis se basó en:
- Cost to Run (Índice de Coste): Se calcula sumando el precio de los tokens de entrada y salida, multiplicado por el volumen de tokens consumidos durante las evaluaciones (sin contar repeticiones). Esto nos da el coste real de “hacer pensar” a la IA.
- Artificial Analysis Intelligence Index v4.0: Este índice de inteligencia es una media ponderada de múltiples pruebas de alto nivel. No solo mide conversación, sino que incluye benchmarks como GDPval-AA para razonamiento de agentes, Bench Telecom para uso de herramientas en entornos técnicos, y otros como SciCode o GPQA Diamond para evaluar conocimientos científicos y lógicos profundos.
Inteligencia vs Rapidez
Para cerrar el artículo, otro de los aspectos que más nos importan a los programadores es usar modelos efectivos y rápidos, especialmente en flujos de atención al cliente o aplicaciones que interactúan directamente con el usuario. En estos entornos, la agilidad de respuesta es un requisito técnico para mantener una buena experiencia de usuario del que muchas veces no se puede prescindir.
El benchmark de Intelligence vs. Output Speed muestra una correlación clara: existe una compensación entre la calidad del modelo y su velocidad de salida. Generalmente, los modelos con mayor capacidad de razonamiento tienden a ser más lentos en la generación de texto.
- Gemini 3 Flash: Se posiciona como el líder absoluto en el cuadrante más atractivo, logrando mantener una inteligencia alta con una velocidad de salida que ronda los 200 tokens por segundo. Es la opción predilecta para flujos que requieren respuestas instantáneas y complejas.
- Grok 4.1 Fast y MiMo-V2-Flash: Presentan un balance sólido, situándose por encima de los 150 tokens por segundo, lo que los hace ideales para micro-tareas rápidas vía API.
- Modelos de Razonamiento: También es notable cómo modelos extremadamente inteligentes como GPT-5.2 (xhigh) o Claude Opus 4.5 ven sacrificada su velocidad, cayendo por debajo de los 100 tokens por segundo. Lo cual explica que estos modelos no están diseñados para esos entornos donde la velocidad es tan importante.
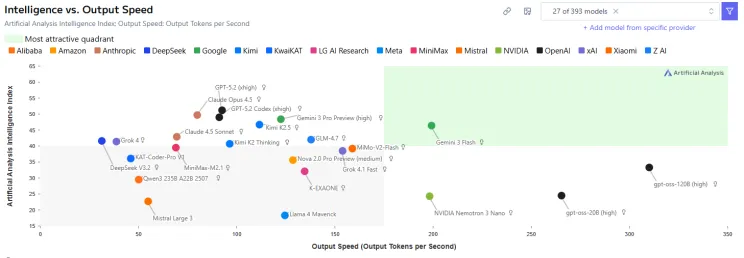
Intelligence vs. Output Speed de Artificial Analysis
Es crucial entender que este benchmark mide la velocidad de salida (tokens por segundo recibidos una vez que comienza la generación). Sin embargo, debemos ser cautos con estos resultados:
Un modelo puede tener un alto flujo de tokens una vez que empieza a escribir, pero si su Time to First Token es elevado porque está “pensando” o realizando llamadas internas, el usuario percibirá un retraso inicial.
Por lo tanto, aunque un modelo brille en velocidad de salida, factores como la latencia de red y el tiempo de computación previo siguen siendo piezas críticas que debemos testear en nuestras implementaciones reales.
Después de analizar esta radiografía del sector a inicios de 2026, me pica la curiosidad: ¿qué resultado os ha dejado más descolocados? ¿Coinciden estos datos con vuestra experiencia diaria o habéis tenido resultados distintos?
Mi recomendación es que no os quedéis solo en la teoría y empecéis a hacer pruebas. Herramientas como OpenRouter son perfectas para esto, ya que os permiten saltar de un modelo a otro y testearlos en vuestros propios flujos de trabajo sin complicaciones.
Preguntas frecuentes
¿Cuál es la mejor IA para escribir textos en español?
Según los datos de febrero de 2026, Gemini 3 Pro: lidera la clasificación de texto de LLM Arena (Elo 1487) y el Multilingual Index en español de Artificial Analysis (94 puntos), seguido muy de cerca por Claude Opus 4.5 (93).
¿Cuál es la mejor IA para programar?
Claude Opus 4.5 en su versión Thinking lidera la clasificación de código de LLM Arena con 1500 puntos. En los benchmarks objetivos de Artificial Analysis (que incluyen SciCode y LiveCodeBench), GPT-5.2, Claude Opus 4.5 y Gemini 3 Pro están prácticamente empatados con 87, 86 y 86 puntos.
¿Qué modelo de IA sale más barato para crear agentes?
DeepSeek V3.2 ofrece una inteligencia similar a la de modelos mucho más caros, y Gemini 3 Flash y Grok 4.1 Fast destacan por su equilibrio entre coste y capacidad. Kimi K2.5 y GLM-4.7 también compiten con los líderes en el índice de agentes de Artificial Analysis.
¿Qué diferencia hay entre LLM Arena y Artificial Analysis?
LLM Arena mide la preferencia humana: los usuarios votan a ciegas entre respuestas de dos modelos y con esos votos se calcula un Elo. Artificial Analysis mide el rendimiento objetivo con exámenes estandarizados (como MMLU-Pro, GPQA o SciCode), además del coste y la velocidad de cada modelo.